Une voix synthétique peut être fluide et expressive, mais la vidéo paraît tout de même artificielle si les plans ne respirent pas au même rythme. Le problème vient rarement d’un seul outil. Il apparaît surtout quand le texte, la durée des phrases et le mouvement visuel sont préparés séparément.
Voici une méthode en cinq passes pour construire un montage cohérent à partir d’images fixes et d’une narration IA.
1. Découper le texte en unités visuelles
Avant de générer la voix, je sépare le script en idées qui peuvent tenir dans un seul plan. Une phrase courte peut durer trois à cinq secondes ; une explication plus dense demande davantage de temps ou deux plans distincts. Ce découpage évite de rallonger artificiellement une image animée lorsque la narration continue.
Chaque unité reçoit une intention simple : présenter un lieu, montrer une action, insister sur un détail ou préparer une transition. Si un plan doit expliquer plusieurs choses à la fois, il sera difficile à synchroniser.
2. Enregistrer une voix témoin avant les images animées
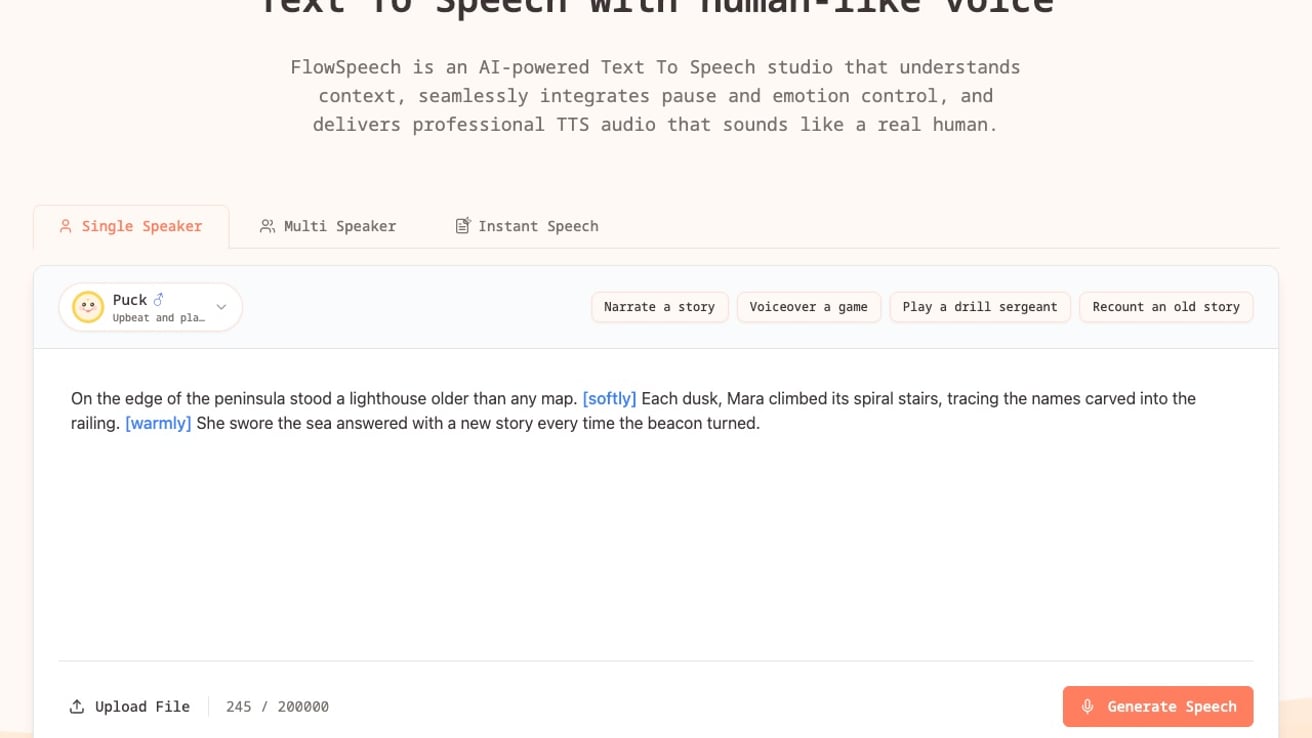
Je produis d’abord une version de travail de la narration. Elle n’a pas besoin d’être définitive, mais ses pauses et son débit doivent déjà être proches du résultat attendu. Cette piste permet de mesurer la durée réelle de chaque séquence au lieu de la deviner.
Je marque ensuite les respirations, les mots importants et les changements d’idée. Ces repères deviennent les points de coupe du montage. Une pause de quelques dixièmes de seconde suffit souvent pour changer de plan sans donner une impression de précipitation.
3. Concevoir des mouvements qui servent la phrase
Pour une phrase descriptive, un mouvement lent de caméra ou un léger déplacement du sujet fonctionne mieux qu’une action complexe. Pour une consigne, le mouvement doit orienter le regard vers l’élément mentionné au bon moment. Plus le texte est chargé, plus le plan visuel doit rester lisible.
Dans mon flux de travail, j’utilise un outil de conversion d’image en vidéo par IA pour tester plusieurs amplitudes de mouvement à partir de la même image. Je conserve la version la plus sobre, puis j’ajuste sa vitesse au montage. Le but n’est pas de montrer le maximum de mouvement, mais d’accompagner l’intention de la voix.
4. Protéger la continuité entre les plans
Les variations de visage, de vêtements, de produit ou de lumière sont plus visibles quand deux plans se suivent rapidement. Je limite donc le nombre d’images sources et je fixe une direction de caméra pour toute la séquence. Quand le sujet doit évoluer, le contrôle de la première et de la dernière image aide à préparer une transition plus prévisible.
Je vérifie aussi les zones fragiles : mains, texte dans l’image, petits objets et arrière-plans répétitifs. Une anomalie discrète sur une image devient souvent très visible dès qu’elle bouge.
5. Finaliser la voix après le premier montage
Une fois les plans assemblés, je reviens à la narration. Je raccourcis certaines phrases, j’allonge une pause ou je remplace un mot si le rythme visuel l’exige. Cette étape est plus efficace que de forcer chaque clip à suivre une voix enregistrée trop tôt.
Le contrôle final se fait sans musique, puis avec la bande sonore complète. Sans musique, les coupes et les silences sont faciles à repérer. Avec la musique, on vérifie que la voix reste prioritaire et que les transitions ne deviennent pas mécaniques.
La cohérence vient des contraintes
Synchroniser une voix IA avec des images animées demande moins d’effets que de décisions cohérentes. Un découpage clair, une voix témoin, des mouvements simples et une révision finale de la narration suffisent souvent à rendre la vidéo plus naturelle.
Transparence : je suis lié à l’outil mentionné dans cet article.
Synchroniser une voix IA avec des plans générés à partir d’images
Une méthode en cinq passes pour aligner narration, durée des plans, mouvements de caméra et transitions sans alourdir le montage.
Voix IA en pratique
2 min ⋅ 17/09/2026